2. הרצה במקביל, שעובדת באמת
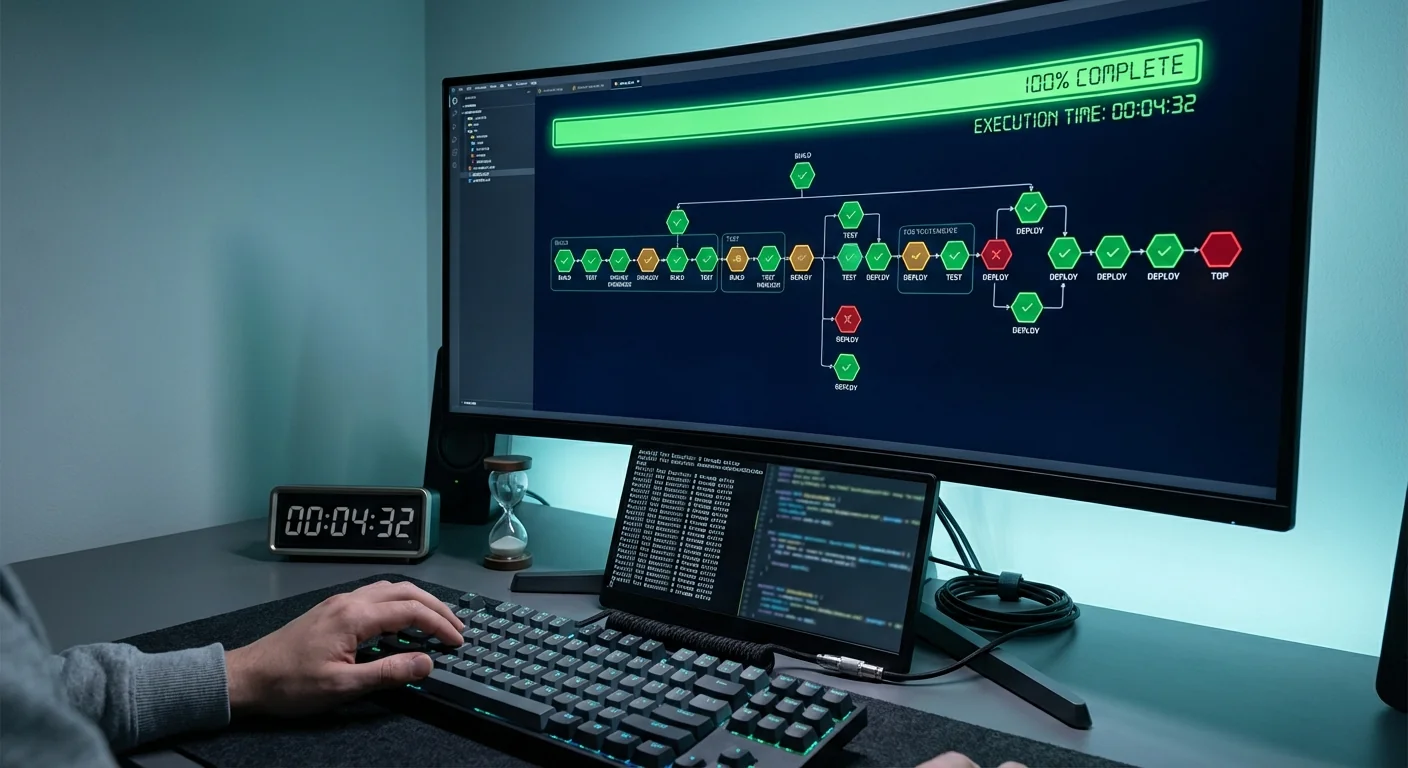
הרבה צוותים אומרים לנו "אנחנו כבר מריצים במקביל". כשאנחנו בודקים, מתברר שהבדיקות רצות במקביל על מכונה אחת, ומוגבלות במעבדים ובזיכרון שלה. הרצה במקביל אמיתית מתפזרת על כמה מכונות.
מה עושים:
- מחלקים את החבילה ל-Shards עצמאיים, שיכולים לרוץ על מכונות נפרדות בלי מצב משותף
- משתמשים בכלים שמחלקים את ה-Shards באופן דינמי (ה-Sharding המובנה של Playwright, או הרצה במקביל ברמת ה-CI עם Matrix ב-GitHub Actions או Parallelism ב-CircleCI)
- מוודאים שהבדיקות לא תלויות בסדר ההרצה או בנתונים משותפים
המכשול שרוב הצוותים נתקלים בו: בידוד הבדיקות. בדיקות שחולקות מצב במסד הנתונים, משתמשות בפורטים שקבועים בקוד או תלויות בשירותים חיצוניים בסדר מסוים לא יכולות לרוץ במקביל בבטחה. קודם מתקנים את הבידוד, ורק אחר כך מריצים במקביל.
התוצאות: חבילה שרצה 45 דקות על מכונה אחת רצה 8 עד 12 דקות על 4 מכונות. עלות המחשוב בענן זניחה, והחיסכון בזמן של המהנדסים מצדיק אותה כבר אחרי הספרינט הראשון.
3. להיפטר מהבדיקות הלא יציבות
בדיקות Flaky עוברות לפעמים ונכשלות לפעמים, בלי שום שינוי בקוד. הן הורגות בשקט את האמון ברגרסיה. כש-5% עד 10% מהחבילה לא יציבים, הצוות מפסיק להאמין לכישלונות ומתחיל להריץ שוב ושוב עד שהכול ירוק. וכשמריצים "עד שזה עובר", חבילת הרגרסיה כבר לא בודקת כלום. היא רק עושה הצגה.
שיטת ההסגר:
1. עוקבים אוטומטית אחרי בדיקות לא יציבות (רוב פלטפורמות ה-CI מזהות בדיקות שנכשלות לסירוגין)
2. מעבירים אותן לחבילת הסגר, שרצה אבל לא חוסמת פריסות
3. בכל ספרינט מהנדס אחד אחראי לתקן או למחוק את הבדיקות שבהסגר
4. כלל: בדיקה שיושבת בהסגר 3 ספרינטים ויותר נמחקת, ובמקומה כותבים חדשה מאפס
שורש הבעיה: 90% מהבדיקות הלא יציבות מגיעות מארבעה מקורות: תלויות בתזמון (המתנה קבועה בקוד במקום המתנה לתנאי), מצב משותף שמשתנה בין בדיקות, תלות בשירותים חיצוניים בלי Mocking, ותזמון של אנימציות בדפדפן בבדיקות E2E.
תקנו את ארבעת הדפוסים האלה, ושיעור הבדיקות הלא יציבות ירד אל מתחת ל-2%.
4. CI/CD שמריץ את הבדיקות הנכונות בזמן הנכון
רגרסיה לא צריכה להיות שלב בלוח הזמנים. היא צריכה להיות שלב אוטומטי ב-Pipeline, שרץ כל הזמן.
ה-Pipeline החדש:
| טריגר | מה רץ | זמן ריצה | מה נחסם |
|---|
| כל PR | בדיקות לפי סיכון, מהמודולים שהשתנו | פחות מ-5 דקות | Merge |
| Merge ל-main | סט מורחב: המודולים שהשתנו והתלויות שלהם | פחות מ-10 דקות | פריסה ל-Staging |
| פריסה ל-Staging | כל חבילת הרגרסיה (במקביל) | פחות מ-20 דקות | פריסה ל-Production |
| אחרי פריסה ל-Production | בדיקות Smoke (10 התהליכים הקריטיים) | פחות מ-2 דקות | מפעיל Rollback |
| כל לילה | כל החבילה, ביצועים ואבטחה | פחות משעה | פותח טיקטים |
מה משתנה: הרגרסיה עוברת מ"3 עד 5 ימים אחרי הפיתוח" ל"20 דקות אחרי ה-Merge, ברקע". הצוות לא מחכה שהרגרסיה תסתיים. הוא מקבל דוח.
5. אופטימיזציה של הבדיקות בעזרת AI
זה תחום חדש יותר, אבל התוצאות כבר מדידות. כלי AI מנתחים את היסטוריית ההרצות שלכם ומזהים:
- בדיקות שמעולם לא תפסו באג (מועמדות למחיקה)
- בדיקות שתמיד עוברות יחד (אפשר להוריד אחת מהן)
- בדיקות שתופסות באגים לעתים קרובות (כדאי להריץ אותן ראשונות, כדי לקבל משוב מהר יותר)
- שינויי קוד שבעבר גרמו לכישלון של בדיקות מסוימות (בחירת בדיקות חזויה)
כלים: Launchable, Testim עם היכולות החזויות שלו, ומודלי ML ייעודיים שמנתחים לוגים של הרצות. ההשקעה: שבוע או שבועיים של הקמה, ועוד כיוונון שוטף.
התוצאות: הטמענו בחירת בדיקות בעזרת AI בחבילת הרגרסיה של לקוח SaaS. הבחירה החזויה הריצה 30% מהחבילה בכל Build ושמרה על שיעור גילוי רגרסיות של 97%. את ה-3% שהיא פספסה תפסה הריצה המלאה בלילה. זמן המשוב הממוצע למפתח ירד מ-42 דקות ל-9 דקות.
לפני ואחרי: מספרים אמיתיים
משלושה פרויקטים של Globalbit שבהם בנינו מחדש את בדיקות הרגרסיה:
| מדד | לקוח פינטק | לקוח איקומרס | לקוח SaaS |
|---|
| מספר בדיקות | מ-4,200 ל-1,100 | מ-2,800 ל-900 | מ-6,100 ל-1,500 |
| זמן ריצה | מ-72 שעות ל-28 דקות | מ-5 ימים ל-22 דקות | מ-8 שעות ל-15 דקות |
| שיעור גילוי באגים | מ-62% ל-78% | מ-58% ל-74% | מ-67% ל-81% |
| שיעור בדיקות לא יציבות | מ-12% ל-1.5% | מ-8% ל-2% | מ-15% ל-1% |
| תדירות פריסות | משבועית ליומית | מפעם בשבועיים ל-3 פעמים בשבוע | משבועית ליומית |
הדפוס עקבי: פחות בדיקות, טובות יותר, שרצות מהר יותר ותופסות יותר. חבילה נפוחה נותנת תחושת ביטחון מזויפת ומאטה את כולם.
שאלות נפוצות
בחירה לפי סיכון לא תפספס באגים בקוד שלא השתנה?
בשביל זה יש את הריצה המלאה בלילה. בחירה לפי סיכון נועדה לתת משוב מהיר ברמת ה-PR, והחבילה המלאה היא רשת הביטחון. בפועל ראינו שבחירה לפי סיכון מפספסת פחות מ-3% מהרגרסיות שהחבילה המלאה תופסת, ואת אלה תופסים תוך 24 שעות.
איך יודעים אילו בדיקות למחוק?
מריצים ניתוח השפעה (Test Impact Analysis): אילו בדיקות תפסו באגים אמיתיים ב-12 החודשים האחרונים? בדיקה שמעולם לא תפסה באג היא מועמדת לבחינה. אל תמחקו בעיניים עצומות. עברו על כל מועמדת והחליטו אם היא מכסה סיכון אמיתי שפשוט עוד לא התממש, או שהיא באמת מיותרת.
הבודקים שלנו לא יודעים להריץ בדיקות במקביל. מי עושה את זה?
בדרך כלל זו משימה של DevOps או של צוות הפלטפורמה, ולא של ה-QA. אם אין לכם את הידע הזה בבית, צוות חיצוני יכול להשלים את הפרויקט תוך 2 עד 3 שבועות. בנינו מחדש חבילות רגרסיה ביותר מ-200 פרויקטים. בואו נדבר על שלכם.
ומה אם המוצר שלנו צמוד מדי, ואי אפשר לבחור בדיקות לפי סיכון?
אז הצימוד ההדוק הוא בעיית האיכות הגדולה שלכם, יותר ממהירות הרגרסיה. התחילו מהרצה במקביל (תיקון 2) ומהיפטרות מבדיקות לא יציבות (תיקון 3), כדי לקצר את זמן הריצה. במקביל השקיעו בפירוק התלויות: גם מודולריזציה חלקית מאפשרת בחירה חלקית לפי סיכון. צריכים עזרה גם בבדיקות וגם בארכיטקטורה? זה בדיוק מה שאנחנו עושים.